1 Introducción
Las Redes Generativas Antagónicas (GANs) representan una clase de modelos generativos propuesta originalmente por Goodfellow et al. (2014). En años recientes, estos modelos han recibido una amplia atención debido a su potencial para modelar datos del mundo real complejos y de alta dimensión.
A diferencia de los enfoques tradicionales, las GANs no minimizan un único criterio de entrenamiento. Su objetivo es estimar la distribución de probabilidad de los datos reales mediante una técnica de aprendizaje adversarial que involucra dos redes neuronales entrenadas simultáneamente. Esta capacidad permite a las GANs generar nuevas muestras infinitamente realistas desde un espacio latente sin depender de suposiciones fuertes sobre la distribución de los datos Hong et al. (2019).
1.1 Arquitectura Básica y Dinámica del Juego
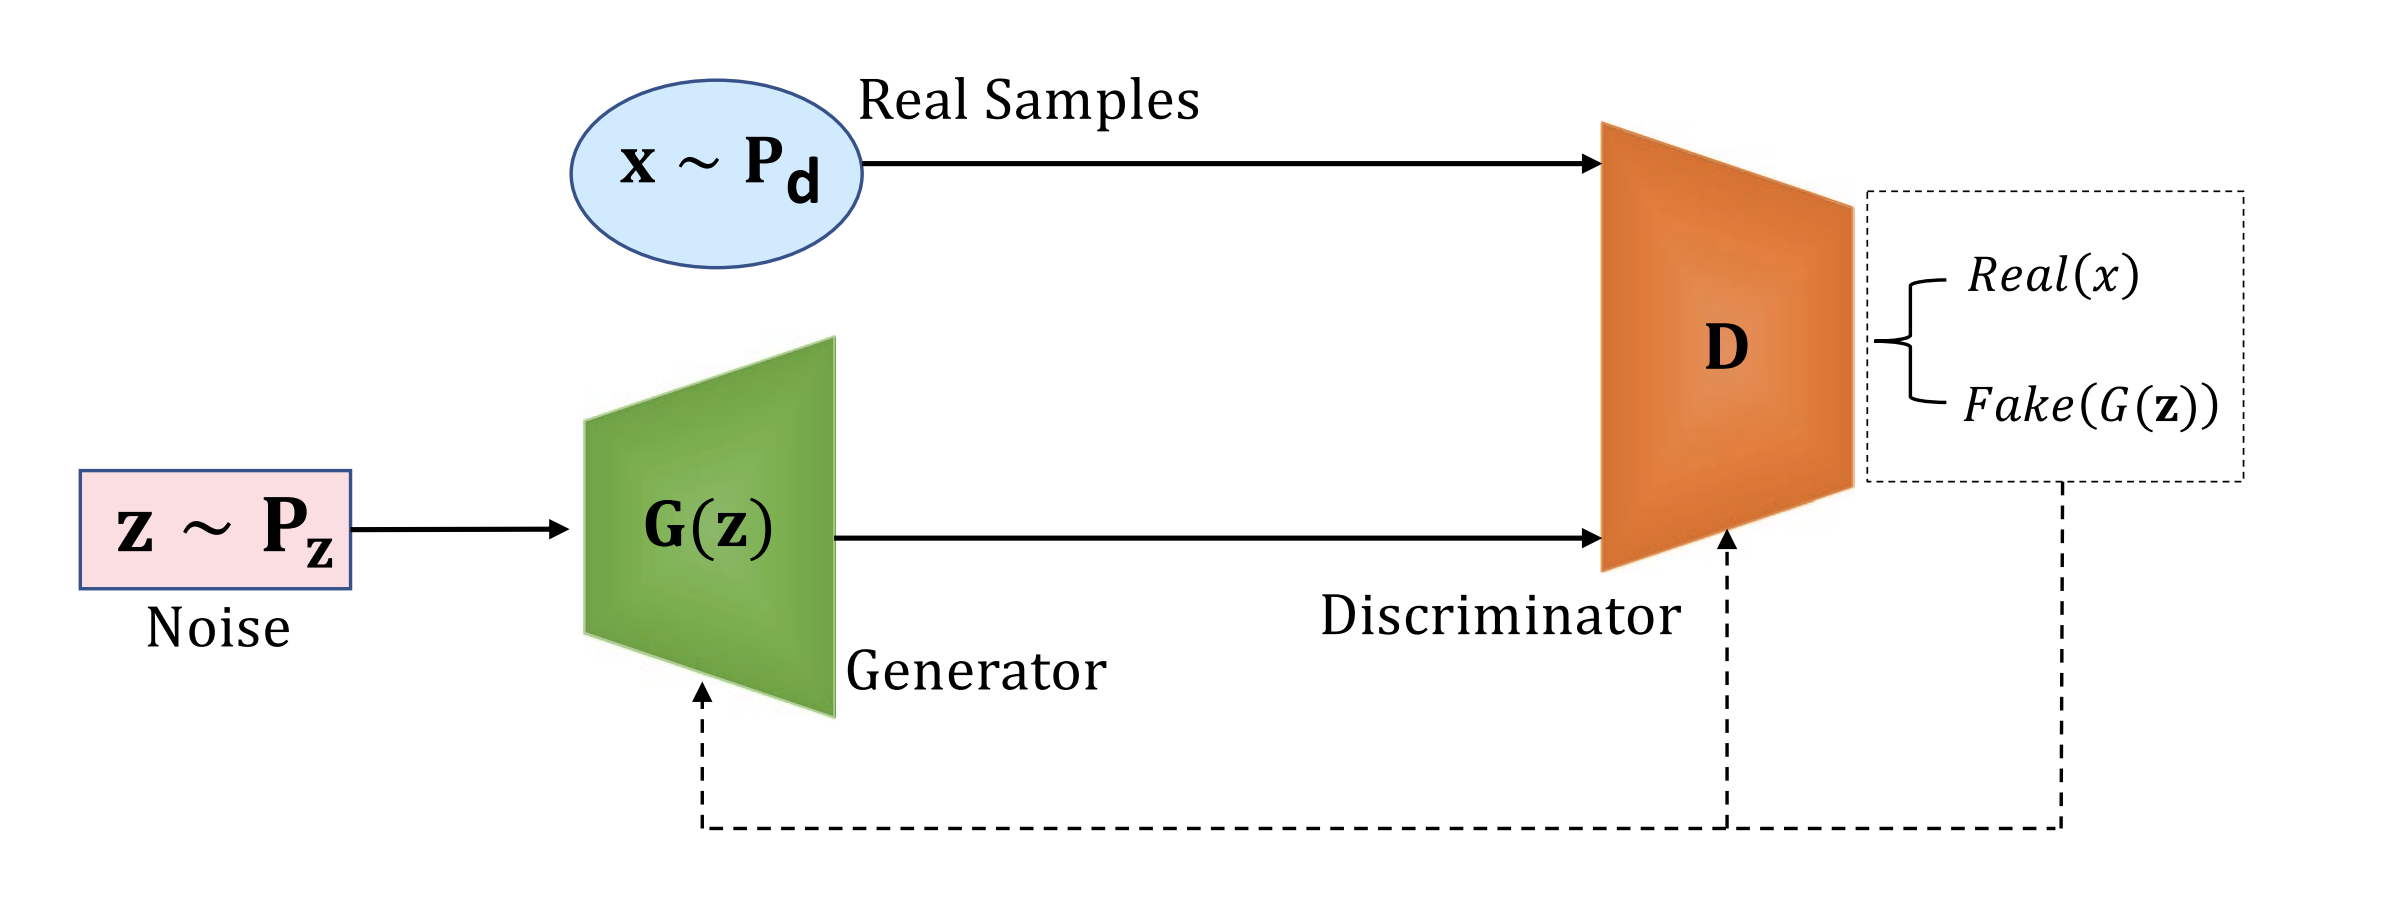
Una GAN se compone usualmente de dos agentes principales:
- El Generador (\(G\)): Intenta crear muestras realistas que no puedan ser distinguidas de los datos genuinos.
- El Discriminador (\(D\)): Intenta diferenciar entre muestras de datos reales y muestras falsas fabricadas por el generador.
La idea central se inspira en un juego minimax de suma cero de dos jugadores. En este juego, la utilidad total es constante (cero); la ganancia o pérdida de un jugador se equilibra exactamente con la pérdida o ganancia del otro. El diseño de las GANs busca alcanzar un Equilibrio de Nash, un estado donde ningún jugador puede incrementar su ganancia cambiando unilateralmente su estrategia Wang et al. (2017).
1.2 Analogía: El Juego Maestro-Estudiante
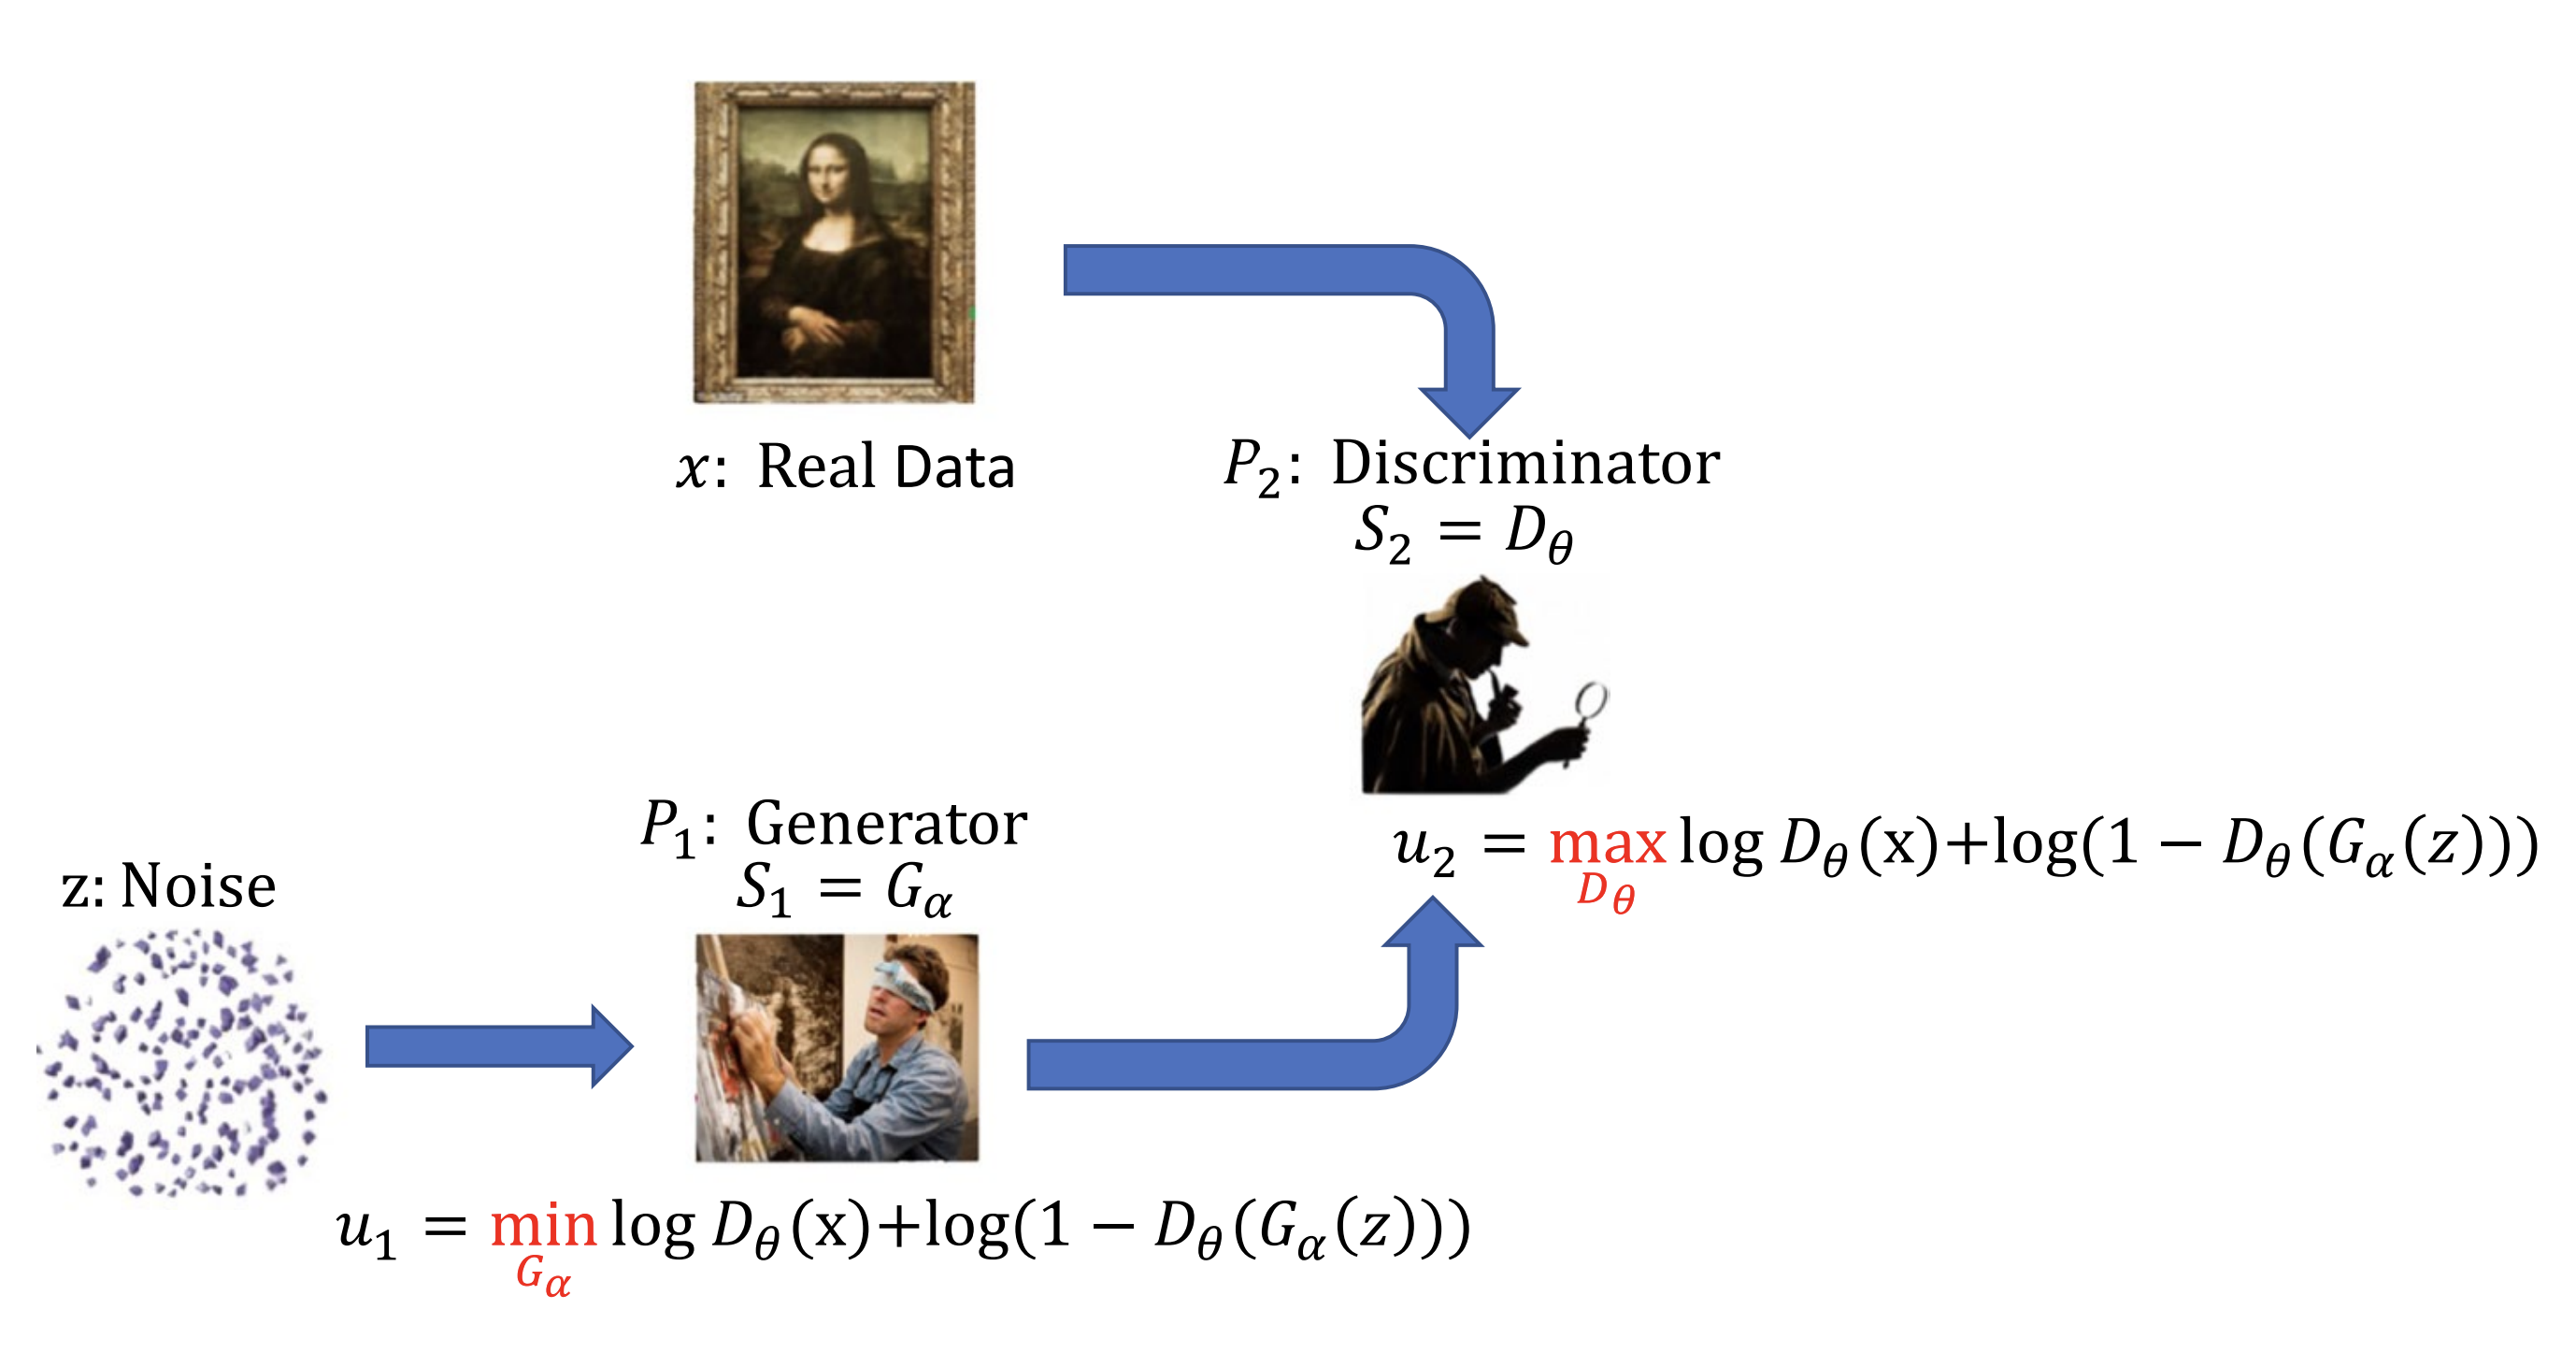
Para comprender mejor este concepto abstracto, podemos visualizar este juego de dos jugadores como una interacción entre un estudiante de arte y su maestro:
- El Estudiante (Generador): Juega el rol de un falsificador o aprendiz que intenta pintar cuadros. Su objetivo es crear obras tan indistinguibles que pasen por auténticas.
- El Maestro (Discriminador): Actúa como un crítico de arte o experto. Su objetivo es enseñar al estudiante discriminando correctamente entre pinturas reales (obras maestras genuinas) y las falsificaciones del alumno.
Para tener éxito en este juego, el estudiante debe aprender a generar pinturas indistinguibles de las reales, y el maestro debe refinar su capacidad de detectar fraudes.
En términos más formales, las “estrategias” de los jugadores corresponden a los pesos de las redes neuronales:
- \(S_1\): Elegir los mejores pesos \(\theta_D\) para el Discriminador.
- \(S_2\): Elegir los mejores pesos \(\theta_G\) para el Generador.
Ambos jugadores intentan maximizar sus respectivos pagos (\(u_1\) y \(u_2\)) para alcanzar el punto de equilibrio.
1.3 Desafíos y Motivación del Enfoque Teórico
A pesar de su éxito significativo en aplicaciones que van desde la síntesis de imágenes hasta la ciberseguridad Alqahtani et al. (2021), la aplicación de GANs a ciertos problemas del mundo real se ha visto obstaculizada por desafíos fundamentales.
El problema más significativo es que las GANs son notoriamente difíciles de entrenar y sufren de problemas de inestabilidad, tales como:
- Colapso de Modo (Mode Collapse): Donde el generador produce una variedad muy limitada de muestras.
- No convergencia: El juego entra en ciclos y no se estabiliza.
- Desvanecimiento de gradientes: El discriminador se vuelve demasiado bueno demasiado rápido, dejando de proveer información útil al generador.
Teóricamente, una GAN necesita converger a un Equilibrio de Nash durante el proceso de entrenamiento, pero tal convergencia ha demostrado ser un desafío algorítmico mayor Wang et al. (2019). Dado una GANs se puede ver como un juego de suma cero, explotar técnicas de teoria de juegos es esencial para mejorar la teoría subyacente y entender estos modelos.
Esta sección esta basada en: Mohebbi Moghaddam et al. (2023), Goodfellow et al. (2014) y Hong et al. (2019).
2 Juegos de Suma Cero y Equilibrio de Nash
2.1 Definición General de un Juego
Un juego en forma normal o estratégica se define formalmente como una tupla \(\Gamma = \langle N, (S_i)_{i \in N}, (u_i)_{i \in N} \rangle\), donde:
- \(N = \{1, \dots, n\}\) es el conjunto finito de jugadores.
- \(S_i\) representa el espacio de estrategias disponibles para el jugador \(i\).
- \(u_i: S \to \mathbb{R}\) es la función de utilidad (o payoff) del jugador \(i\), que asigna un valor escalar a cada perfil de estrategia resultante Nisan et al. (2007).
Para el propósito de este trabajo, nos centraremos en juegos donde los espacios de estrategia pueden ser continuos (como en redes neuronales), pero fundamentaremos la teoría en juegos matriciales finitos.
2.2 Definiciones y Configuración del Juego Matricial
Para establecer la notación que utilizaremos en las demostraciones (ver Apéndices), consideramos un juego de dos jugadores, I y II.
2.2.1 Matrices de Pago
Definimos las interacciones mediante matrices que contienen las recompensas para cada combinación de acciones puras:
- \(A \in \mathbb{R}^{m \times n}\): Matriz de pagos para el Jugador I.
- \(B \in \mathbb{R}^{m \times n}\): Matriz de pagos para el Jugador II.
2.2.2 Estrategias: Puras y Mixtas
Distinguimos entre dos tipos de decisiones:
- Estrategias Puras: La elección determinista de una acción específica del conjunto finito disponible.
- Estrategias Mixtas: Una distribución de probabilidad sobre las acciones puras. Esto permite modelar la incertidumbre o la aleatorización en la toma de decisiones.
- Para el Jugador I: \(\mathbf{x} = (x_1, \ldots, x_m)^T \in \Delta_m\).
- Para el Jugador II: \(\mathbf{y} = (y_1, \ldots, y_n)^T \in \Delta_n\).
Donde \(\Delta_k\) denota el símplex estándar de dimensión \(k\), definido como el conjunto de vectores no negativos cuya suma es 1: \[ \Delta_k = \{ z \in \mathbb{R}^k \mid z_i \ge 0, \sum z_i = 1 \} \]
2.2.3 Espacio de Estrategias Conjuntas (\(K\))
El estado del juego está determinado por el par \((\mathbf{x}, \mathbf{y})\). El conjunto de todos los perfiles posibles es el producto cartesiano: \[ K = \Delta_m \times \Delta_n \]
Es importante notar que, dado que cada símplex \(\Delta\) es un conjunto cerrado y acotado (compacto) y convexo, su producto \(K\) hereda estas propiedades. \(K\) es un conjunto cerrado, convexo y compacto en el espacio euclidiano(esta propiedad es clave para la demostración de la existencia de Equilibrios de Nash en el Apéndice A).
2.2.4 Pago Esperado
La utilidad en estrategias mixtas no es un valor determinista, sino una esperanza. Dada una estrategia conjunta \((\mathbf{x}, \mathbf{y})\), los pagos esperados se calculan mediante formas bilineales:
- Pago a I: \(u_I(\mathbf{x}, \mathbf{y}) = \mathbf{x}^T A\mathbf{y} = \sum_{i,j} x_i a_{ij} y_j\).
- Pago a II: \(u_{II}(\mathbf{x}, \mathbf{y}) = \mathbf{x}^T B\mathbf{y} = \sum_{i,j} x_i b_{ij} y_j\).
Esto representa el promedio ponderado de los pagos, donde cada resultado \(a_{ij}\) se multiplica por la probabilidad conjunta de que ocurra.
2.3 Juegos de Suma Cero
Un caso especial y fundamental para las GANs son los juegos estrictamente de suma cero. Aquí, los intereses son diametralmente opuestos: lo que gana uno es exactamente lo que pierde el otro. \[ \forall (\mathbf{x}, \mathbf{y}) \in K: \quad u_I(\mathbf{x}, \mathbf{y}) + u_{II}(\mathbf{x}, \mathbf{y}) = 0 \]
Esto implica que \(B = -A\). Por tanto, podemos describir el juego completo usando solo la matriz \(A\) y una única Función de Valor \(V\):
\[ V(\mathbf{x}, \mathbf{y}) = \mathbf{x}^T A \mathbf{y} \]
Los objetivos de optimización se vuelven antagónicos sobre esta misma función:
Jugador I (Maximizador): Busca \(\mathbf{x}\) para maximizar \(\mathbf{x}^T A \mathbf{y}\).
Jugador II (Minimizador): Busca \(\mathbf{y}\) para maximizar \(\mathbf{x}^T (-A) \mathbf{y}\), lo que equivale a minimizar \(\mathbf{x}^T A \mathbf{y}\).
El valor del juego en equilibrio se formaliza como el problema minimax: \[ \min_{\mathbf{y} \in \Delta_n} \max_{\mathbf{x} \in \Delta_m} \mathbf{x}^T A \mathbf{y} \]
2.4 El Equilibrio de Nash
Un perfil de estrategias \((\mathbf{x}^*, \mathbf{y}^*)\) constituye un Equilibrio de Nash (NE) si ningún jugador puede mejorar su utilidad desviándose unilateralmente.
Formalmente, \((\mathbf{x}^*, \mathbf{y}^*)\) es un NE si satisface simultáneamente:
\[ \mathbf{x}^{*T} A \mathbf{y}^* \geq \mathbf{x}^T A \mathbf{y}^* \quad \forall \mathbf{x} \in \Delta_m \]
\[ \mathbf{x}^{*T} A \mathbf{y}^* \leq \mathbf{x}^{*T} A \mathbf{y} \quad \forall \mathbf{y} \in \Delta_n \]
(Nota: La segunda desigualdad es \(\leq\) porque el Jugador II minimiza \(V\)).
La demostración de existencia de este equilibrio se detalla en el Apéndice A. Sin embargo, encontrarlo en espacios no convexos de alta dimensión (como en aprendizaje profundo) es un desafío algorítmico mayor Daskalakis et al. (2018).
2.4.1 Ejemplo 1: Dilema del Prisionero (Suma NO Cero)
Para ilustrar la diferencia, consideremos un juego donde \(B \neq -A\). Dos prisioneros deciden si cooperar (\(C\)) o traicionar (\(D\)). Matriz de pagos \((A, B)\):
\[ \begin{array}{c|cc} & \text{P2: C} & \text{P2: D} \\ \hline \text{P1: C} & (-1, -1) & (-3, 0) \\ \text{P1: D} & (0, -3) & (-2, -2) \end{array} \]
Aquí, la estrategia pura (D, D) es el único Equilibrio de Nash, demostrando que el equilibrio individual no siempre lleva al óptimo global cooperativo (C, C).
2.4.2 Ejemplo 2: Matching Pennies (Suma Cero)
Este ejemplo es análogo a la dinámica de las GANs. P1 gana si coinciden, P2 gana si difieren. \(A\) para el Jugador 1 (\(B=-A\)):
\[ A = \begin{array}{c|cc} & \text{P2: Cara} & \text{P2: Cruz} \\ \hline \text{P1: Cara} & +1 & -1 \\ \text{P1: Cruz} & -1 & +1 \end{array} \]
Aquí no existe equilibrio en estrategias puras. Si P1 juega Cara, P2 cambia a Cruz, etc. El equilibrio solo existe en el interior del símplex (estrategias mixtas): \(\mathbf{x}^* = (0.5, 0.5), \mathbf{y}^* = (0.5, 0.5)\).
2.5 El Teorema Minimax y Puntos Silla
En juegos de suma cero, el Equilibrio de Nash tiene una conexión profunda con el Teorema Minimax de von Neumann (ver Apéndice B para la demostración). Este teorema establece que el valor que el maximizador puede asegurar es igual al valor que el minimizador puede forzar.
Gracias a las propiedades de convexidad y compacidad de los espacios de estrategias mixtas (\(\Delta_m, \Delta_n\)), el orden de los operadores es intercambiable:
\[ \max_{\mathbf{x} \in \Delta_m} \min_{\mathbf{y} \in \Delta_n} \mathbf{x}^T A \mathbf{y} = \min_{\mathbf{y} \in \Delta_n} \max_{\mathbf{x} \in \Delta_m} \mathbf{x}^T A \mathbf{y} = V^* \]
2.5.1 El Punto Silla como Equilibrio
Geométricamente, extendiendo esto a funciones continuas generales \(V(\theta_G, \theta_D)\) (como en las GANs), un Equilibrio de Nash equivale a encontrar un punto silla.
Un perfil \((\theta_G^*, \theta_D^*)\) es un punto silla si es un máximo local para \(G\) y un mínimo local para \(D\): \[ V(\theta_G, \theta_D^*) \leq V(\theta_G^*, \theta_D^*) \leq V(\theta_G^*, \theta_D) \]
Implicación para GANs: El entrenamiento de GANs busca este punto donde la distribución generada \(p_g\) coincide con \(p_{data}\). Sin embargo, los métodos de gradiente estándar (SGD) suelen fallar en converger a puntos silla en paisajes no convexos, presentando oscilaciones o ciclos Mescheder et al. (2017).
Esta sección esta basada en: Karlin y Peres (2017) y Nisan et al. (2007)
3 GANs
En este capítulo, formalizamos las Redes Generativas Antagónicas como un problema de optimización en un espacio de funciones de densidad de probabilidad, analizando las propiedades de convergencia teórica del juego minimax inducido.
3.1 Definición Formal del Modelo
Una Red Generativa Antagónica (GAN) puede definirse formalmente como una tupla \(\Omega = \langle p_{data}, (G, p_z), D, \phi \rangle\), donde:
- Distribución de Datos (\(p_{data}\)): Es la densidad de probabilidad desconocida definida sobre el espacio de datos \(x \in \mathbb{R}^d\) que deseamos modelar.
- Generador (\(G, p_z\)):
- \(z \in \mathbb{R}^k\) es un vector aleatorio latente muestreado de una distribución a priori fija \(p_z\) (e.g., \(\mathcal{N}(0, I)\)).
- \(G: \mathbb{R}^k \times \Theta_G \to \mathbb{R}^d\) es una función diferenciable (red neuronal) parametrizada por \(\theta_G\).
- \(G\) induce una distribución de probabilidad implícita \(p_g\) en el espacio de datos (formalmente, \(p_g\) es la medida pushforward de \(p_z\) bajo \(G\), denotada como \(G_{\#}p_z\)).
- Discriminador (\(D\)):
- \(D: \mathbb{R}^d \times \Theta_D \to [0, 1]\) es una función diferenciable parametrizada por \(\theta_D\).
- \(D(x)\) representa la probabilidad estimada de que \(x\) provenga de \(p_{data}\) en lugar de \(p_g\).
- Función de Medición (\(\phi\)): Una función convexa \(\phi: [0, 1] \to \mathbb{R}\) que define la métrica de divergencia.
3.2 El Juego Inducido de Suma Cero
El entrenamiento de una GAN se modela como un juego de suma cero donde las estrategias puras son los vectores de parámetros \(\theta_G \in \Theta_G\) y \(\theta_D \in \Theta_D\).
La función de utilidad (valor) del juego, \(V(G, D)\), se define como la esperanza de la evaluación correcta del discriminador sobre ambas distribuciones:
\[ V(G, D) = \mathbb{E}_{x \sim p_{data}} [\phi(D(x))] + \mathbb{E}_{z \sim p_z} [\phi(1 - D(G(z)))] \]
En la formulación original de Goodfellow et al. (2014) (Vanilla GAN), utilizamos \(\phi(t) = \ln(t)\), lo que resulta en la función de pérdida de entropía cruzada binaria:
\[ V(G, D) = \mathbb{E}_{x \sim p_{data}} [\ln D(x)] + \mathbb{E}_{z \sim p_z} [\ln(1 - D(G(z)))] \]
Nota: Variaciones como la Wasserstein GAN (WGAN) modifican \(\phi\) (e.g., \(\phi(t) = t\)) y eliminan la restricción sigmoide en \(D\), cambiando la naturaleza de la convergencia, aunque aquí nos centraremos en la formulación logarítmica clásica.
El objetivo global es encontrar el equilibrio minimax (Nash) dado por:
\[ \min_{G} \max_{D} V(G, D) \]
3.3 Análisis del Óptimo
Para analizar la convergencia teórica, asumimos temporalmente que \(G\) y \(D\) tienen capacidad infinita (espacio de funciones no paramétrico) y analizamos el óptimo en el espacio de funciones de densidad.
3.3.1 El Discriminador Óptimo
Consideremos el generador \(G\) fijo. Queremos encontrar la función \(D^*\) que maximiza \(V(G, D)\). Reescribimos la función de valor en términos de integrales sobre el espacio de datos \(\mathcal{X}\):
\[ V(G, D) = \int_{\mathcal{X}} p_{data}(x) \ln(D(x)) \, dx + \int_{\mathcal{Z}} p_z(z) \ln(1 - D(G(z))) \, dz \]
Haciendo un cambio de variable para la segunda integral, expresamos todo sobre el soporte de \(x\). Sea \(p_g(x)\) la densidad inducida por \(G(z)\):
\[ V(G, D) = \int_{\mathcal{X}} \left( p_{data}(x) \ln(D(x)) + p_g(x) \ln(1 - D(x)) \right) \, dx \]
Proposición 1. Para un generador \(G\) fijo, el discriminador óptimo \(D^*_G(x)\) está dado por la razón: \[ D^*_G(x) = \frac{p_{data}(x)}{p_{data}(x) + p_g(x)} \]
Demostración. El problema de maximización se puede resolver puntualmente para cada \(x\). Definimos la función \(J(y)\) para \(y \in [0, 1]\) dados escalares \((a, b) \in \mathbb{R}^2 \setminus \{(0,0)\}\): \[J(y) = a \ln(y) + b \ln(1 - y)\] Derivando respecto a \(y\) e igualando a cero: \[ \frac{\partial J}{\partial y} = \frac{a}{y} - \frac{b}{1-y} = 0 \implies a(1-y) = by \implies y = \frac{a}{a+b} \] Sustituyendo \(a = p_{data}(x)\) y \(b = p_g(x)\), y observando que la segunda derivada es negativa (máximo), obtenemos el resultado. \(\blacksquare\)
OBS: El discriminador óptimo no está definido fuera del soporte \(\text{Supp}(p_{data}) \cup \text{Supp}(p_g)\).
3.3.2 La función de costo del Generador
Sustituyendo el discriminador óptimo \(D^*_G\) en la función de valor, reducimos el juego minimax a una minimización pura sobre \(G\). Llamamos a esta función reformulada \(C(G)\):
\[ \begin{aligned} C(G) &= \max_{D} V(G, D) = V(G, D^*_G) \\ &= \mathbb{E}_{x \sim p_{data}} \left[ \ln \frac{p_{data}(x)}{p_{data}(x) + p_g(x)} \right] + \mathbb{E}_{x \sim p_g} \left[ \ln \frac{p_g(x)}{p_{data}(x) + p_g(x)} \right] \end{aligned} \]
Podemos relacionar esta expresión con la Divergencia de Kullback-Leibler (\(KL\)) y la Divergencia de Jensen-Shannon (\(JSD\)). Recordando que \(KL(P \| Q) = \int p(x) \ln \frac{p(x)}{q(x)} dx\):
\[ C(G) = -\ln(4) + KL\left(p_{data} \Big\| \frac{p_{data} + p_g}{2}\right) + KL\left(p_g \Big\| \frac{p_{data} + p_g}{2}\right) \]
Esto es exactamente igual a: \[ C(G) = -\ln(4) + 2 \cdot JSD(p_{data} \| p_g) \]
Teorema (Mínimo Global). El mínimo global de la función de costo del generador \(C(G)\) se alcanza si y solo si la distribución generada coincide con la real (\(p_g = p_{data}\)). En este punto, el valor del juego es \(-\ln(4)\).
Demostración:
La función objetivo derivada es: \[C(G) = -\ln(4) + 2 \cdot JSD(p_{data} \| p_g)\]
Cota Inferior: Por definición, la Divergencia de Jensen-Shannon es no negativa (\(JSD \geq 0\)). Por lo tanto, el valor mínimo posible de \(C(G)\) está acotado inferiormente por \(-\ln(4)\).
Condición de Igualdad: La propiedad fundamental de la divergencia establece que \(JSD(P \| Q) = 0\) si y solo si \(P = Q\) en casi todo punto.
Esto implica que para minimizar \(C(G)\), el generador debe satisfacer \(p_g = p_{data}\).
Interpretación del Valor \(-\ln(4)\): Si \(p_g = p_{data}\), el discriminador óptimo es incapaz de distinguir las muestras, colapsando a la incertidumbre máxima: \(D^*(x) = \frac{1}{2}\). Evaluando la función de costo original bajo esta condición: \[ \mathbb{E}[\ln(1/2)] + \mathbb{E}[\ln(1-1/2)] = \ln(1/4) = -\ln(4) \]
Esto confirma que el equilibrio de Nash ocurre cuando el generador recupera perfectamente la distribución de datos y el discriminador opera como un clasificador aleatorio. \(\blacksquare\)
3.4 Algoritmo de Entrenamiento
En la práctica, no optimizamos en el espacio de funciones, sino mediante Descenso de Gradiente Estocástico en el espacio de parámetros \(\Theta_D, \Theta_G\).
Para un minibatch de tamaño \(m\) y \(T\) épocas, el procedimiento de Goodfellow et al. (2014) es:
- Muestrear \(m\) ruidos \(z^{(i)}\) de \(p_z\) y \(m\) datos \(x^{(i)}\) de \(p_{\mathrm{data}}\).
- Actualizar el discriminador por ascenso de gradiente: \[\nabla_\phi \frac{1}{m}\sum_{i=1}^{m}\bigl[\log D_\phi(x^{(i)})+\log\bigl(1-D_\phi(G_\theta(z^{(i)}))\bigr)\bigr].\]
- Actualizar el generador por descenso de gradiente: \[\nabla_\theta \frac{1}{m}\sum_{i=1}^{m}\log\bigl(1-D_\phi(G_\theta(z^{(i)}))\bigr).\]
3.5 Convergencia Teórica
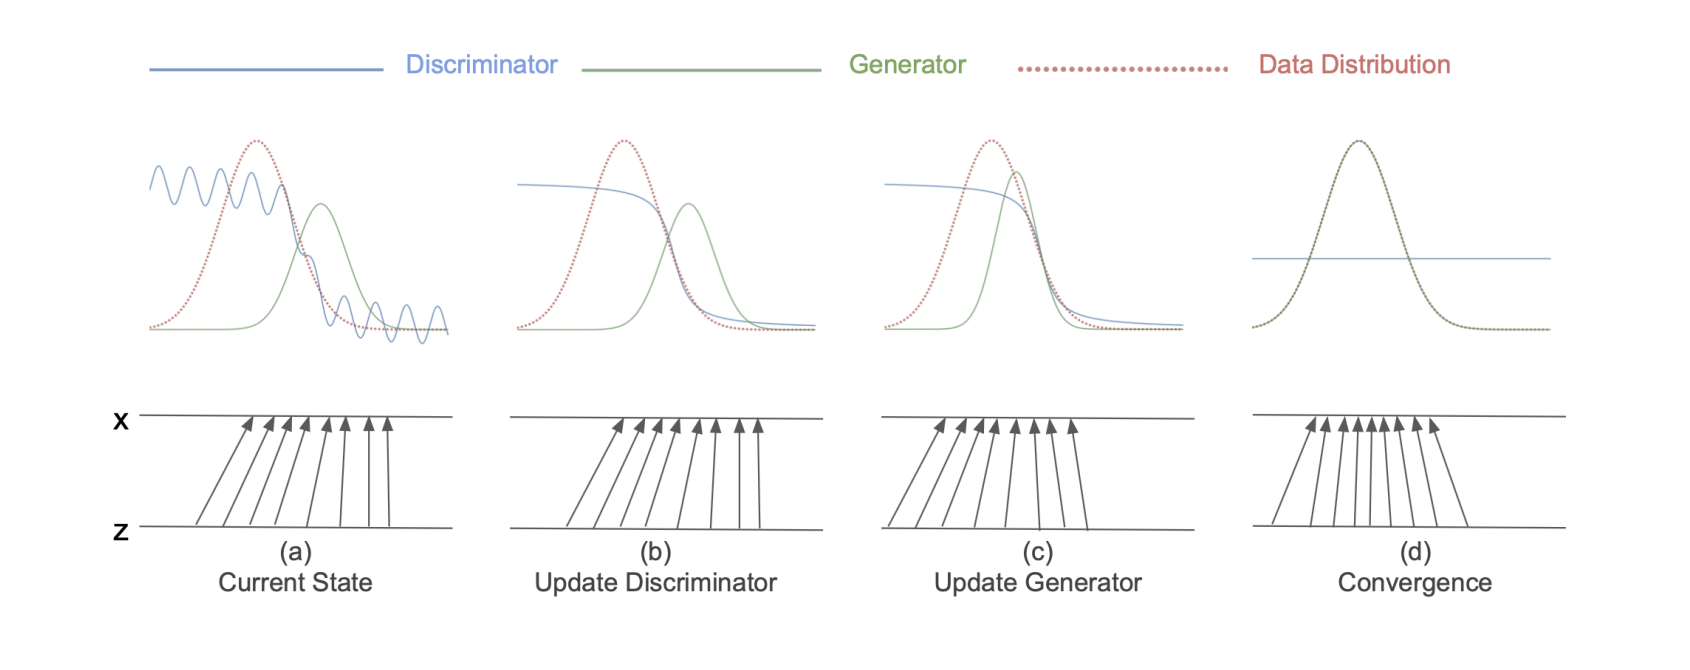
Formalmente, bajo el análisis clásico de Goodfellow et al. (2014), la convergencia está garantizada si asumimos condiciones ideales:
\(G\) y \(D\) tienen capacidad infinita (espacio de funciones no paramétrico).
En cada paso iterativo del generador, se permite a \(D\) alcanzar su óptimo global \(D^*_G\).
\(p_g\) se actualiza siguiendo el gradiente para minimizar el criterio \(C(G)\).
Bajo estas hipótesis, se demuestra que la distribución generada \(p_g\) converge a la distribución real \(p_{data}\), alcanzando el Equilibrio de Nash donde \(D(x) = 1/2\) en todo el dominio.
Sin embargo, en la práctica, estas condiciones no se cumplen. Un problema crítico es el desvanecimiento de gradientes. A lo largo de los años, se han propuesto numerosas variantes de GANs (e.g., WGAN, LSGAN, etc.) para mitigar estos problemas y mejorar la estabilidad del entrenamiento Arjovsky et al. (2017) Mao et al. (2017). Sin embargo no van a ser cubiertas en este trabajo por motivos de extensión.
Esta sección esta basada en: Goodfellow et al. (2014), Hong et al. (2019), Farnia y Ozdaglar (2020) y Ermon et al. (2023)
4 Apéndices
4.1 Apéndice A: Demostración del Teorema de Nash (Existencia)
En este apéndice presentamos la demostración de la existencia de un Equilibrio de Nash en estrategias mixtas para juegos finitos de 2 jugadores. Ya que las GANs hay 2 jugadores,aunque el argumento se puede extender a \(n\) jugadores facilmente,
4.1.1 A. Definiciones y Configuración del Juego
Consideramos un juego de suma general con dos jugadores, I (con \(m\) acciones puras) y II (con \(n\) acciones puras).
Matrices de Pago:
- \(A_{m \times n}\): Matriz de pagos para el Jugador I.
- \(B_{m \times n}\): Matriz de pagos para el Jugador II.
Estrategias Mixtas:
- \(\mathbf{x} = (x_1, \ldots, x_m)^T \in \Delta_m\) (Estrategia de I, donde \(\Delta_m\) es el símplex \(m\)-dimensional estándar).
- \(\mathbf{y} = (y_1, \ldots, y_n)^T \in \Delta_n\) (Estrategia de II).
Espacio de Estrategias Conjuntas (\(K\)):
El conjunto de todos los perfiles de estrategias posibles es el producto cartesiano de los espacios de estrategias individuales: \[ K = \Delta_m \times \Delta_n \] Propiedad topológica clave: Dado que cada símplex es un conjunto cerrado, convexo y acotado, su producto \(K\) también es un conjunto cerrado, convexo y acotado (compacto) en el espacio euclidiano.
Pago Esperado:
Los pagos esperados dada una estrategia conjunta \((\mathbf{x}, \mathbf{y})\) son:
- Pago a I: \(u_I(\mathbf{x}, \mathbf{y}) = \mathbf{x}^T A\mathbf{y}\).
- Pago a II: \(u_{II}(\mathbf{x}, \mathbf{y}) = \mathbf{x}^T B\mathbf{y}\).
4.1.2 B. Definición de Equilibrio de Nash
Antes de proceder a la demostración, definimos formalmente el objeto de estudio. Un par de estrategias \((\mathbf{x}^*, \mathbf{y}^*) \in K\) es un Equilibrio de Nash si ninguna desviación unilateral es rentable para ningún jugador.
Formalmente, \((\mathbf{x}^*, \mathbf{y}^*)\) es un equilibrio si y solo si:
\[ \begin{aligned} \mathbf{x}^{*T} A \mathbf{y}^* &\ge \mathbf{x}^T A \mathbf{y}^* \quad \forall \mathbf{x} \in \Delta_m \\ (\mathbf{x}^*)^T B \mathbf{y}^* &\ge (\mathbf{x}^*)^T B \mathbf{y} \quad \forall \mathbf{y} \in \Delta_n \end{aligned} \]
Esto es equivalente a decir que \(\mathbf{x}^*\) es una mejor respuesta a \(\mathbf{y}^*\) y viceversa.
4.1.3 C. Construcción de la Función de Mapeo \(T\)
Para probar la existencia de dicho equilibrio, utilizamos el Teorema del Punto Fijo de Brouwer:
Teorema (Brouwer): Si \(K\) es un conjunto compacto y convexo, y \(T: K \to K\) es una función continua, entonces existe al menos un punto fijo \(\mathbf{z}^* \in K\) tal que \(T(\mathbf{z}^*) = \mathbf{z}^*\).
El objetivo es construir una función \(T\) tal que sus puntos fijos coincidan con los Equilibrios de Nash.
4.1.3.1 Incentivos de Desviación
Para cada acción pura \(i\) del Jugador I, definimos \(c_i\) como la ganancia marginal positiva que obtendría el jugador al cambiar toda su masa de probabilidad a la acción pura \(i\) frente a la estrategia actual \(\mathbf{y}\) del oponente:
\[ c_i(\mathbf{x}, \mathbf{y}) := \max \left\{ A_i \mathbf{y} - \mathbf{x}^T A\mathbf{y}, \ 0 \right\} \]
Donde \(A_i \mathbf{y}\) es el pago de jugar la acción pura \(i\). Nota: Si la acción \(i\) da menos pago que el promedio actual, \(c_i = 0\).
De manera simétrica, para el Jugador II y cada acción pura \(j\):
\[ d_j(\mathbf{x}, \mathbf{y}) := \max \left\{ \mathbf{x}^T B_j - \mathbf{x}^T B\mathbf{y}, \ 0 \right\} \]
4.1.3.2 Definición del Mapeo \(T(\mathbf{x}, \mathbf{y})\)
Definimos la función \(T: K \to K\) que transforma \((\mathbf{x}, \mathbf{y})\) en un nuevo par \((\hat{\mathbf{x}}, \hat{\mathbf{y}})\). La intuición es que \(T\) “empuja” la probabilidad hacia las acciones que tienen un incentivo de desviación positivo (\(c_i > 0\) o \(d_j > 0\)).
Definimos los factores de normalización \(S = \sum_{k=1}^m c_k\) y \(D = \sum_{k=1}^n d_k\).
Las nuevas estrategias se calculan como:
\[ \hat{x}_i = \frac{x_i + c_i}{1 + S}, \quad \hat{y}_j = \frac{y_j + d_j}{1 + D} \]
Es fácil verificar que \(\sum \hat{x}_i = 1\) y \(\sum \hat{y}_j = 1\), por lo que el mapeo está bien definido dentro de \(K\).
4.1.4 D. Propiedades y Demostración
4.1.4.1 Continuidad de \(T\)
Las funciones de pago esperado son multilineales y, por tanto, continuas. La función \(\max\{\cdot, 0\}\) es continua. Dado que el denominador \((1+S)\) es siempre \(\ge 1\) (nunca cero), la composición resultante \(T(\mathbf{x}, \mathbf{y})\) es una función continua.
4.1.4.2 Existencia del Punto Fijo
Dado que \(K\) es compacto y convexo, y \(T\) es continua, por el Teorema de Brouwer existe un punto \((\mathbf{x}^*, \mathbf{y}^*) \in K\) tal que: \[ T(\mathbf{x}^*, \mathbf{y}^*) = (\mathbf{x}^*, \mathbf{y}^*) \] Esto implica que \(\hat{\mathbf{x}} = \mathbf{x}^*\) y \(\hat{\mathbf{y}} = \mathbf{y}^*\).
4.1.4.3 Verificación: El Punto Fijo es un Equilibrio de Nash
Debemos demostrar que en el punto fijo, los incentivos de desviación desaparecen (\(S=0\) y \(D=0\)).
Analicemos al Jugador I. En el punto fijo se cumple: \[ x^*_i = \frac{x^*_i + c_i}{1 + S} \quad \iff \quad x^*_i(1 + S) = x^*_i + c_i \quad \iff \quad x^*_i S = c_i \] Esto implica que \(c_i\) es proporcional a \(x^*_i\) escalado por \(S\).
Supongamos por contradicción que la estrategia actual no es un equilibrio, es decir, existe alguna mejora posible, lo que implica \(S > 0\). Si \(S > 0\), entonces debe existir al menos un \(k\) tal que \(c_k > 0\).
Consideremos la ganancia ponderada por la mejora. Sabemos que: \[ \sum_{i=1}^m c_i (A_i \mathbf{y}^* - (\mathbf{x}^*)^T A\mathbf{y}^*) = \sum_{i=1}^m c_i^2 \] Esto se debe a que si \(A_i \mathbf{y}^* - (\mathbf{x}^*)^T A\mathbf{y}^* < 0\), entonces \(c_i = 0\), anulando el término.
Sin embargo, usando la propiedad del punto fijo \(c_i = x^*_i S\): \[ \sum_{i=1}^m x^*_i S (A_i \mathbf{y}^* - (\mathbf{x}^*)^T A\mathbf{y}^*) = S \left[ \underbrace{\sum_{i=1}^m x^*_i A_i \mathbf{y}^*}_{(\mathbf{x}^*)^T A \mathbf{y}^*} - \underbrace{\sum_{i=1}^m x^*_i (\mathbf{x}^*)^T A\mathbf{y}^*}_{(\mathbf{x}^*)^T A \mathbf{y}^*} \right] = S \cdot 0 = 0 \]
Llegamos a la contradicción: \(\sum c_i^2 = 0\), lo cual implica que \(c_i = 0\) para todo \(i\).
Conclusión: Si \(c_i = 0\) para todo \(i\), entonces por definición: \[ A_i \mathbf{y}^* - (\mathbf{x}^*)^T A\mathbf{y}^* \le 0 \quad \implies \quad A_i \mathbf{y}^* \le (\mathbf{x}^*)^T A\mathbf{y}^* \] Esto significa que ninguna acción pura da un pago mayor al de la estrategia mixta actual. Por linealidad, ninguna estrategia mixta alternativa dará un pago mayor.
El mismo argumento aplica para el Jugador II (\(D=0\)). Por lo tanto, el punto fijo \((\mathbf{x}^*, \mathbf{y}^*)\) satisface las condiciones del Equilibrio de Nash.
La prueba es una adaptación de la demostración que se hace en Karlin y Peres (2017). Gracias a Diego por prestarnos el libro :)
4.2 Apéndice B: Demostración del Teorema Minimax (Von Neumann)
El Teorema Minimax de Von Neumann es fundamental en la Teoría de Juegos de suma cero. Este teorema establece que el valor Maximin del Jugador I es igual al valor Minimax del Jugador II.
4.2.1 Teorema Minimax de Von Neumann
Sea \(A\) una matriz de pagos de \(m \times n\). El valor del juego \(V\) satisface:
\[ \max_{x\in\Delta_m} \min_{y\in\Delta_n} x^T Ay = V = \min_{y\in\Delta_n} \max_{x\in\Delta_m} x^T Ay \]
La demostración se basa en el Teorema del Hiperplano Separador de la geometría convexa, procediendo en dos partes.
4.2.2 Parte 1: La Desigualdad (Maximin \(\leq\) Minimax)
La primera parte de la demostración es inmediata y se basa en la propiedad de que el máximo de un mínimo es siempre menor o igual al mínimo de un máximo para cualquier función continua \(f(x, y)\) sobre conjuntos compactos.
Formalmente, demostramos: \[ \max_{x\in\Delta_m} \min_{y\in\Delta_n} x^T Ay \leq \min_{y\in\Delta_n} \max_{x\in\Delta_m} x^T Ay \]
- Para cualquier par de estrategias \(\tilde{x} \in \Delta_m\) y \(\tilde{y} \in \Delta_n\), se tiene trivialmente: \[ \min_{y\in\Delta_n} \tilde{x}^T Ay \leq \tilde{x}^T A\tilde{y} \leq \max_{x\in\Delta_m} x^T A\tilde{y} \]
- Dado que la desigualdad \(\min_{y} \tilde{x}^T Ay \leq \max_{x} x^T A\tilde{y}\) se cumple para cualquier \(\tilde{x}\) y \(\tilde{y}\), podemos tomar el máximo sobre \(\tilde{x}\) en el lado izquierdo y el mínimo sobre \(\tilde{y}\) en el lado derecho, manteniendo la desigualdad. \[ \max_{x\in\Delta_m} \min_{y\in\Delta_n} x^T Ay \leq \min_{y\in\Delta_n} \max_{x\in\Delta_m} x^T Ay \]
4.2.3 Parte 2: La Igualdad (Minimax \(\leq\) Maximin)
El objetivo ahora es demostrar que el lado izquierdo debe ser al menos tan grande como el lado derecho, lo que fuerza la igualdad.
Se prueba por contradicción usando el Teorema del Hiperplano Separador.
4.2.3.1 A. Hipótesis de Contradicción
Asumimos que la igualdad no se cumple y que existe una brecha, es decir, que existe un número \(\lambda\) tal que:
\[ \lambda < \min_{y\in\Delta_n} \max_{x\in\Delta_m} x^T Ay \]
Esto implica que el valor Minimax (\(V_{II}\)) es estrictamente mayor que \(\lambda\).
4.2.3.2 B. Transformación del Juego
Definimos una nueva matriz de pagos \({\hat{A}}\) con \(\hat{a}_{i,j} = a_{i,j} - \lambda\). Para este nuevo juego, el valor Minimax debe ser positivo:
\[ 0 < \min_{y\in\Delta_n} \max_{x\in\Delta_m} x^T {\hat{A}} y \]
4.2.3.3 C. Construcción del Conjunto Convexo \(K\)
Definimos el conjunto \(K \subseteq \mathbb{R}^m\), que representa todos los vectores que dominan los posibles vectores de ganancia del Jugador I en el juego \({\hat{A}}\):
\[ K = \{{\hat{A}} y + v : y \in \Delta_n, v \in \mathbb{R}^m, v \geq \mathbf{0}\} \]
- El conjunto \(K\) es cerrado y convexo.
- Se comprueba que \(\mathbf{0} \notin K\). Si \(\mathbf{0} \in K\), existiría un \(y \in \Delta_n\) tal que \({\hat{A}} y \leq \mathbf{0}\), implicando que \(\max_{x} x^T {\hat{A}} y \leq 0\), lo cual contradice la positividad establecida en el paso B.
4.2.3.4 D. Aplicación del Teorema del Hiperplano Separador
Dado que \(K\) es cerrado y convexo y no contiene el origen, el Teorema del Hiperplano Separador (Theorem 2.6.2) garantiza la existencia de un vector \(\mathbf{z} \in \mathbb{R}^m\) y una constante \(c > 0\) tal que:
\[ \mathbf{z}^T w > c > 0 \quad \text{para todo } w \in K \]
Sustituyendo la definición de \(w = {\hat{A}} y + v\): \[ \mathbf{z}^T ({\hat{A}} y + v) > c > 0 \quad \text{para todo } y \in \Delta_n \text{ y } v \geq \mathbf{0} \]
4.2.3.5 E. Identificación de la Estrategia \(\tilde{x}\)
- Restricción en \(\mathbf{z}\): Se demuestra que \(\mathbf{z} \geq \mathbf{0}\). Si algún componente \(z_j < 0\), la elección de un \(v\) adecuado anularía la desigualdad.
- Normalización: Ya que \(\mathbf{z} \geq \mathbf{0}\) y \(\mathbf{z} \neq \mathbf{0}\), se define una estrategia mixta \(\mathbf{\tilde{x}} \in \Delta_m\): \[ {\tilde{x}} = \frac{\mathbf{z}}{\sum_{i} z_i} \in \Delta_m \]
4.2.3.6 F. Conclusión por Contradicción
Al elegir \(v = \mathbf{0}\) y sustituir \(\mathbf{z} = (\sum z_i) {\tilde{x}}\) en la desigualdad del hiperplano, se obtiene:
\[ (\sum z_i) {\tilde{x}}^T {\hat{A}} y > c \]
Dividiendo por la suma positiva \((\sum z_i)\) y volviendo al juego original \(A\) (\(\mathbf{\hat{A}} = A - \lambda I\)):
\[ {\tilde{x}}^T A y - \lambda > \frac{c}{\sum z_i} > 0 \]
Esto implica que \({\tilde{x}}^T A y\) es estrictamente mayor que \(\lambda\) para todo \(y \in \Delta_n\). Por lo tanto, el Maximin del juego \(A\) es mayor que \(\lambda\):
\[ \max_{x\in\Delta_m} \min_{y\in\Delta_n} x^T Ay > \lambda \]
Dado que esto es cierto para cualquier \(\lambda\) menor que el Minimax (según nuestra hipótesis inicial), la única conclusión posible es que el Maximin debe ser mayor o igual que el Minimax, forzando la igualdad:
\[ \max_{x\in\Delta_m} \min_{y\in\Delta_n} x^T Ay = \min_{y\in\Delta_n} \max_{x\in\Delta_m} x^T Ay \]
La prueba es una adaptación de una presenteación sobre GANs de Matias Carrasco, gracias mati :)